虹科案例
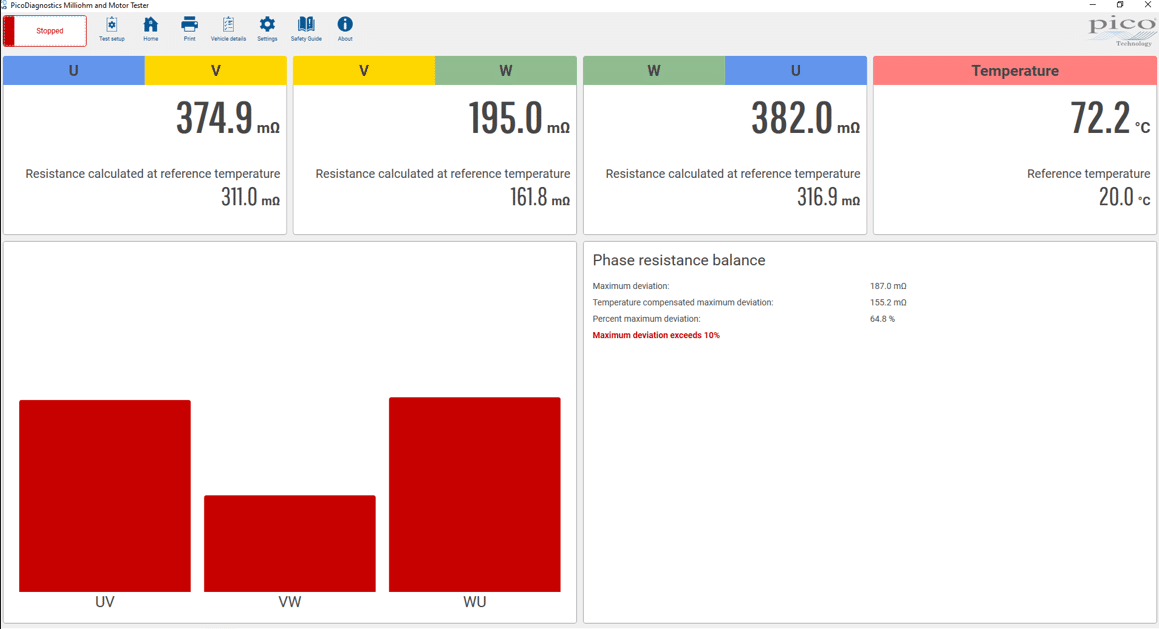
【虹科案例】用 Pico MT03A 破解 BMW Valvetronic 故障碼
BMW 報 DTC 135808 與 135B11 故障只能盲目換件?揭密如何利用 Pico MT03A 毫歐表與 PicoScope 示波器精準破解 Valvetronic 診斷迷思!實測定位 190 mΩ 馬達繞組不平衡與 5V 浮動接地,避免誤判開路,大幅提升汽車高級診斷效率!
Lorem ipsum dolor sit amet, consectetur adipiscing elit.Ut elit tellus, luctus nec ullamcorper mattis, pulvinar dapibus leo.
多模型數據庫(Multi-model Database)之所以出現,核心背景往往不是「數據庫種類不夠」,而是業務系統的複雜度持續攀升,讓單一模型很難同時滿足「屬性查詢」與「關係遍歷」的混合需求。當「關聯式數據庫(Relational DB)+ 圖數據庫(Graph DB)」被放進同一條業務鏈路、一起承載關聯型業務邏輯時,系統架構複雜度常會以非線性的速度上升,且上升幅度往往超出設計初期的預期。
常見的架構演進路徑是:原本的關聯式數據庫繼續存放實體數據與核心欄位;新增圖數據庫專門存放實體間的關係,主攻多跳查詢(Multi-hop Traversal);然後由應用層(Application Layer)負責把兩邊的結果「黏」回同一個回傳物件。設計文件上看起來邊界清楚:關聯式回答「數據是什麼」、圖數據庫回答「數據怎麼連」,但真實世界的查詢需求幾乎不會乖乖待在單一模型裡。
實務上,多數查詢都是「屬性 + 關係」的混合型態:先撈取「近 30 天活躍用戶」(屬性過濾,偏向關聯式),再看這批人之間的好友/互動關係(多跳遍歷,偏向圖數據庫);或先找出「高風險帳戶」(屬性與交易紀錄過濾),再沿著關聯路徑往外擴散排查潛在關係人。這些在業務語意上其實是一個閉環,但在「關聯式 + 圖數據庫」混用的架構下,會被迫拆成多段流程:先在關聯式數據庫過濾出 ID 清單、再同步或即時推送到圖數據庫、在圖裡面做遍歷、最後回到應用層進行二次拼裝與加工。真正吞噬企業開發成本的,往往是「跨系統拼接查詢語意」,而不是某一個數據庫本身。
接著,技術團隊會遇到更棘手的數據一致性(Data Consistency)問題:
為了補救這些架構漏洞,團隊通常會加上事件驅動架構(Event-driven Architecture)/訊息隊列(Message Queue)、補償機制、定期檢核與修復任務,並在業務層接受某種程度的最終一致性(Eventual Consistency);但這些「補強」措施會逐步把系統重心從創造業務價值,轉移到容錯與糾錯之上。
更容易被忽略、但殺傷力極強的是交易/事務(Transaction)語意被拆碎:原本在單一數據庫中,一個業務操作可以包在同一個 ACID 交易裡,失敗就完整回滾(Rollback);混用之後,一次業務操作變成多次跨系統寫入,強一致性(Strong Consistency)常退化成最終一致性,回滾邏輯也被迫上移到應用層手動編寫。結果就是:狀態判斷充斥在核心流程中、錯誤處理「入侵」業務程式碼、系統行為變得越來越難以推理。排查一個問題需要跨兩套數據庫與整條呼叫鏈,定位成本大幅飆升。
當複雜度累積到某個臨界點,架構反而會限制業務的演進速度:一個微小的需求可能同時需要修改關聯式數據庫、圖數據庫、同步管道(Pipelines)與應用層拼裝;一個小異常可能要跨多個技術棧(數據庫、隊列、服務)追查數天。團隊的技術決策變得越來越保守,因為任何改動都可能踩爆既有的跨系統耦合點。這時,企業即便擁有了很強的圖查詢能力,也常常被「整合與一致性成本」徹底吞沒。
所以問題不在「圖數據庫」本身,而在於「分裂的數據視圖(Split Data Views)」:同一個業務視圖被硬生生拆成兩套(實體/屬性在關聯式,關係在圖數據庫),應用層被迫承擔「整合數據語意」的責任,而這本來應該盡量由數據層去吸收。業界也常把「同一個應用同時使用多種數據庫」的策略稱為多語言持久化(Polyglot Persistence),其優點是各取所長,但代價是整合與一致性難度更高、維運與營運複雜度大幅提升。
回到多模型數據庫(Multi-model Database)的解決思路:核心重點是「統一」,而不是在同一條核心鏈路上不斷地「疊加」技術棧。它想回答的是:
以 ArangoDB 為例,其官方文件明確列出在單機(Single Server)情境下,多文件/多集合(Multi-document/Multi-collection)查詢可提供完整的 ACID 交易/事務保證。
最後虹科(HongKe)想要強調:「關聯式 + 圖數據庫」的混用架構並非原罪,但它有其嚴格的前提:業務邊界足夠清楚、系統規模可控、且團隊有足夠的人力與資源長期承擔數據同步與一致性的維護成本。如果您企業當前的主要矛盾已經是系統複雜度本身,那麼再試圖用「多加一個數據庫」去解決單點問題,很容易陷入「越疊加、越臃腫」的惡性循環。多模型數據庫的架構價值,恰恰在於透過「少一種拆分」,去大幅減少跨系統技術黏合所帶來的隱性隱藏成本。
BMW 報 DTC 135808 與 135B11 故障只能盲目換件?揭密如何利用 Pico MT03A 毫歐表與 PicoScope 示波器精準破解 Valvetronic 診斷迷思!實測定位 190 mΩ 馬達繞組不平衡與 5V 浮動接地,避免誤判開路,大幅提升汽車高級診斷效率!
深度剖析企業如何從單次 LLM API 呼叫跨越至自主 Agentic 系統。本文整理零售、金融等六大行業的 AI Agent 生產環境部署實例,並解構高併發、跨互動記憶(Memory Infrastructure)與分散式狀態持久化等底層基礎設施邏輯。
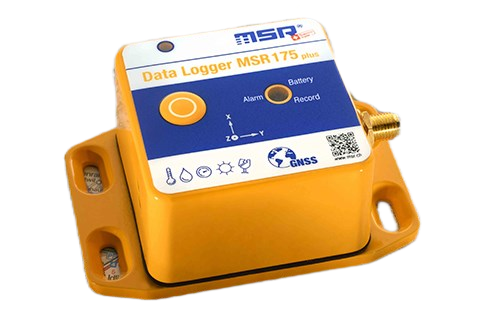
半導體晶圓與光罩跨國運輸如何避免震動受損?揭密台積電選用虹科 MSR175Plus 衝擊及振動數據記錄儀的關鍵原因!產品具備長效續航與大容量記憶體,能精準記錄長途運輸中的溫濕度、壓力與多軸加速度。專訪台積電工程師,分享如何將震動轉化為量化數據並訂立嚴謹標準,有效降低受損風險並大幅提升跨國運輸成功率!