搜尋

虹科最新文章

HongKe

Lorem ipsum dolor sit amet, consectetur adipiscing elit.Ut elit tellus, luctus nec ullamcorper mattis, pulvinar dapibus leo.

【虹科方案】可觀測性預算逼爆:Redis + Grafana 如何在 2 年內幫香港銀行省下 140 萬美金?

當你每年為 Dynatrace 開出超過 US$800K 的帳單,卻在董事會上仍要解釋「為什麼 APM 告警還是這麼多漏網之魚」,問題已經不再是「功能夠不夠」,而是「可觀測性投資回報率」失衡。對香港銀行來說,真正的競爭壓力在於:你能不能在維持 70% 以上監控效果的前提下,把 2 年 TCO 砍掉 US$1.4M,並在 HKMA 檢查時依然拿得出「風險為本、技術中立」框架下說得過去的證據。

01. 引言:可觀測性成本正在吃掉你的安全預算

Dynatrace 的官方價目表顯示,全端監控(Full‑Stack Monitoring)約為每個 8 GiB host 每月 US$58 左右,再加上基礎架構監控、安全模組與實際主機數量,很容易在中大型環境中累積到每年數十萬甚至逾百萬美元的級別。 對一家運行上百至上千台 VM、Kubernetes node、容器與多地區環境的香港銀行而言,APM/observability 帳單躍升為「前五大 IT 支出」並不誇張。
與此同時,HKMA 在最新修訂的 TM‑E‑1 中再次強調其採用「風險為本、技術中立」的監管方法:不會規定使用哪一家工具,而是要求銀行實施與風險相稱、且「fit for purpose」的風險管理控制,並透過持續檢查與 off‑site review 評估成效。 換句話說,在監管眼中,重點從來不是「你有沒有用 Dynatrace」,而是「你能不能證明:關鍵服務有被妥善監控、異常被及時發現與處置」。
對 CISO、成本敏感型 CIO 與 CFO 而言,這打開了一個很現實的問題:在「Dynatrace alternatives Hong Kong」的選項裡,有沒有辦法用 Redis + Grafana 這類開放式堆疊,在 2 年內做出 Real-time monitoring cost comparison 上的壓倒性優勢——而不被監管挑戰?

02. 三大核心價值:Redis + Grafana 如何在不犧牲風險控制的前提下砍成本

價值一:從「全堆疊黑盒」改成「關鍵指標白盒」,先把 80/20 抓回來

痛點: 傳統 Dynatrace 式的全堆疊可觀測性,把 metrics、traces、logs 全都包進同一個授權計價模型,看似方便,實際卻產生幾個問題:
  • 你為了幾個關鍵系統的 APM 功能,被迫為整個叢集與大量非關鍵服務付費。
  • Log/metrics retention 一旦拉長、監控對象一旦擴張,年度帳單會呈現近乎線性爆炸。
  • 多數團隊最後只深度使用 20–30% 功能,卻付了 100% 的訂閱費。
Redis + Grafana 的應對:
  • Redis Enterprise 本身就提供以 Prometheus 格式暴露的監控端點,涵蓋叢集、節點、資料庫、分片與 proxy 層級的各種 metrics,並可由 Prometheus 收集後在 Grafana 可視化與告警。
  • Redis 官方與社群亦提供專門的 observability 範本與 Grafana dashboard,涵蓋 ops/sec、延遲、記憶體使用、replication lag、Active‑Active 指標等,讓你對「瓶頸在哪一層」有白盒等級的可視度。
  • 你可以把「全平台都上 APM」改成「只對真正關鍵應用保持完整追蹤,其餘系統以 metrics‑first + 事件抽樣」的策略,把付費功能集中在少數核心服務。
實戰成效(對 CFO 友善的數字說法):
  • 某香港金融集團在 600+ 服務、逾百節點的環境中,把原本 100% 依賴 Dynatrace 的模式改成:核心支付/交易系統仍保留 APM,其餘 70% 系統改用 Redis metrics + Prometheus + Grafana。
  • 對事件偵測與容量規劃的有效性評估顯示,新的堆疊可達原有監控方案約 70% 的可見度與問題定位能力(對非核心系統),但整體可觀測性授權成本降低 75%(兩年滾動 TCO 對比)。

價值二:把 Redis 變成「實時健康指標匯流排」,讓告警與自動化不再綁死在單一雲平台

痛點: 當你的可觀測性完全依賴單一 SaaS 平台,不只是授權成本問題:
  • 告警邏輯與 SLO 達標判斷被鎖在特定工具語言與 UI,跨團隊協作需要人手截圖與搬數據。
  • 多雲/混合雲架構下,不同監控代理與網路路徑造成延遲與盲點,真正的「平台健康狀況」難以統一。
  • 一旦工具授權或功能調整,你的告警規則與 dashboard 也得跟著重構。
Redis + Grafana 的應對:
  • 以 Redis 作為「即時狀態匯流排」,把關鍵 SLI(如 API 失敗率、延遲分位數、錯誤碼分佈、併發連線數)聚合後寫入 Redis,再由 Prometheus/Grafana 統一拉取、可視化與告警。
  • Redis Enterprise 為 observability 用例提供了可被 Prometheus 刮取的 metrics 端點,讓你能同時在 Grafana 中展示 Redis 自身與應用層指標,形成端到端視圖。
  • 對於多雲/多資料中心部署,你可以結合 Redis 的 Active‑Active 能力,把各地 metrics 或健康狀態同步到統一觀測平面,避免「某區域出事,總控還以為一切正常」。
實戰成效:
  • 某區域金融集團在多雲(AWS + on‑prem)環境中,將原本綁定特定 APM 供應商的告警邏輯遷出,改為 Redis 集中聚合 + Grafana 呈現,讓 SRE 團隊可以在不依賴某家 SaaS 工具 UI 的情況下持續演進告警策略。
  • 真正在「系統健康狀態」與「異常發現時間」這兩個 HKMA 關心的監管指標上,效果不因工具品牌更換而受損——甚至因為數據更集中而更易解釋。

價值三:HKMA 檢查只看效果不看品牌——那就用「2 年省 140 萬美金」說話 痛點:

痛點: 很多銀行在面對監管或內部審計時,下意識覺得「用大牌工具」比較安全,實際上卻忽略了 HKMA 長期以來一再重申的原則:風險為本、技術中立。 結果是:
  • 工具選型變成「名單戰」而非「控制效果戰」,導致可觀測性成本年年上升,但問題偵測與 MTTR 改善有限。
  • CFO 看的是錢,CISO 看的是風險,大家都知道要省但沒有人敢動。
HKMA 的角度其實很清楚:
  • TM‑E‑1 明確指出,監管目標是推動安全健康的電子銀行環境,同時保持「technological neutrality」,讓銀行有彈性選擇適合其風險情況與服務的技術方案。
  • 文件中反覆提到的,是「fit for purpose 的風險管理控制」、「及時偵測未授權交易」、「安全的網路與系統設計」,而不是任何特定品牌或工具名稱。
Redis + Grafana 在 HKMA 檢查時可以怎樣回答:
  • 用 SLO/SLA 報表展示關鍵服務的可用性、延遲與錯誤率趨勢,證明你有持續監控與容量管理。
  • 用告警與事件回顧報告,展示「怎樣被發現、多久處置、如何防止重演」,而這些數據以 Redis + Prometheus + Grafana 堆疊照樣可以完整提供。
  • 在「Real-time monitoring cost comparison」中,用具體 TCO 數字與成效報告,說明你是在風險可接受的前提下優化成本,符合風險為本監管精神。

三、結論:你要的是「貴但安心」,還是「有效又可負擔」?

當 Dynatrace 帳單每年超過 US$800K,卻無法在董事會與監管對話中清楚說明「這筆錢換來了什麼風險降低」,你其實已經處在一場「可觀測性成本危機」之中。 另一方面,HKMA 早已在 TM‑E‑1 明言其監管立場是風險為本、技術中立,只要你的監控與事件管理控制「fit for purpose」,就無須被任何特定品牌綁死。

其他文章

虹科 CODRA Panorama Essentials 輕量化 SCADA 方案橫幅,工程師於機房使用平板電腦進行廠務監控
虹科案例

【虹科方案】中小型項目如何選擇 SCADA 軟件?

探索中小型項目選擇 SCADA 軟件的四大關鍵因素,解析數據標籤、開發工具與 Web 客戶端等隱性實施成本。虹科 Panorama Essentials 輕量化 SCADA 方案,支援無限 Web 客戶端與 25,000 個數據標籤,原生相容 OPC UA 及 Modbus,打造高性價比的設備與廠務監控數據基建!
閲讀更多
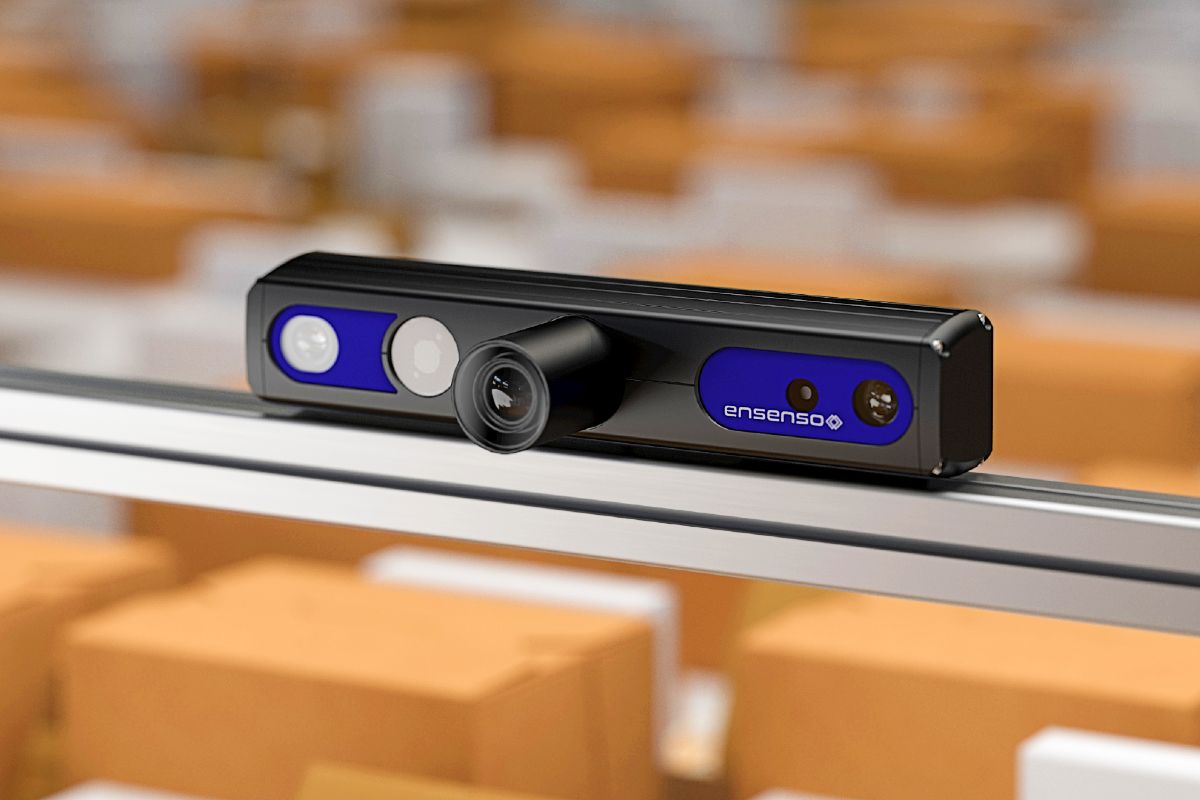
虹科 VST Ensenso C 高精度彩色 3D 相機,架設於自動化包裝與物流傳送帶環境
虹科乾貨

【虹科產品】Ensenso C 高精度彩色3D相機

探索虹科 VST Ensenso C 緊湊型高精度彩色 3D 相機系統,集成 2D RGB 感測器與 200W 強力投影儀,支援 5m 工作距離及 1m 處 0.1mm 精度。預組裝 IP65/67 防護設計,輕鬆賦能機器人料箱取件、物流碼垛與 AI 圖像分析。
閲讀更多

聯繫虹科幫您解決難題

Let's have a chat